
家里台式机在吃灰,笔记本跑本地模型卡成幻灯片,想玩AI智能体却被一块显卡的算力卡死——这种”设备很多、算力不够”的尴尬,英伟达上周给出了一个零成本的解法。9月4日,英伟达在IFA 2026上发布了免费开源工具NVIDIA PAIR(Personal AI Router,个人AI路由器),它能把家里局域网内的多台电脑自动组成一个本地AI算力网络。这篇实测带你搞清楚它到底能干什么、怎么用、值不值得装。
NVIDIA PAIR是什么:让闲置电脑”组队”的免费软件
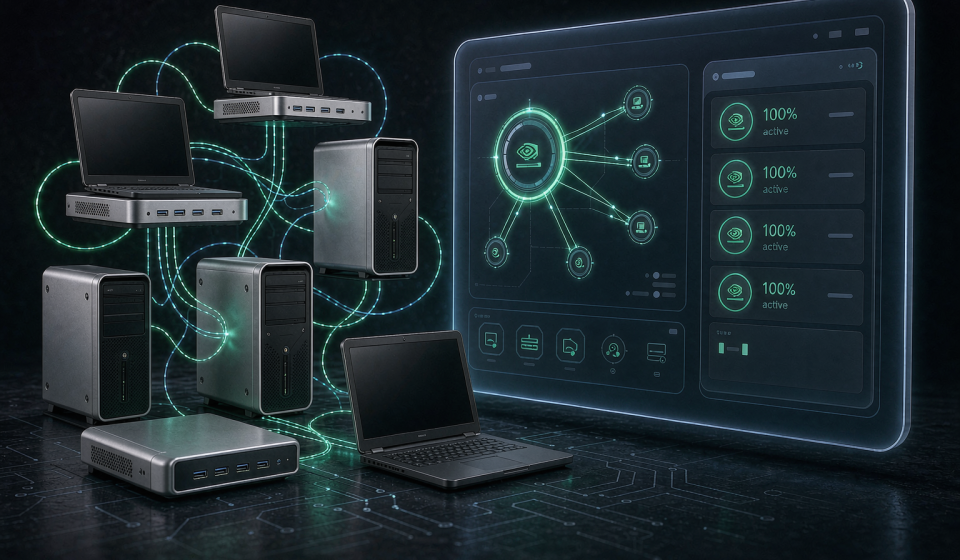
先澄清一个误区:PAIR名字里带”路由器”,但它不是硬件,而是一款纯软件工具。它的核心逻辑很简单——超过一半的家庭拥有两台以上电脑,这些设备的GPU大部分时间在闲置。PAIR会通过mDNS自动发现同一局域网内的兼容设备,把相互独立的AI推理请求智能路由到”有空”的机器上,而不是让所有任务都排队等同一块显卡。
上手流程只有三步:第一,在每台电脑上下载安装PAIR(提供图形界面和终端两种方式);第二,首次配对时输入六位数验证码完成设备绑定,之后通信全程走mTLS双向加密,数据不出内网;第三,配合Ollama或LM Studio使用,PAIR会自动接管任务分发。断网也能跑——下载好模型后,整套系统可以零联网运行,这对在意隐私的用户是个实打实的卖点。
硬件门槛不高:NVIDIA GeForce RTX 20系列及更新的显卡、RTX PRO工作站卡、DGX Spark,甚至苹果M4及更新芯片都能加入。系统支持Windows 11、macOS和Linux,内存至少8GB、磁盘留20GB即可。
实测表现:18分钟的任务,三台机器8分48秒跑完
PAIR最擅长的场景是智能体工作流——主Agent把复杂任务拆成多个子任务,分给几个子Agent并行执行。单机跑这种任务时,所有请求挤一块GPU,队列越长越慢;PAIR把子任务分发到不同机器,速度直接翻倍。
英伟达给出的官方测试很有代表性:用Qwen 3.6 35B A3B模型跑一个五子智能体的收件箱整理任务,单台RTX Spark笔记本耗时18分钟;换成PAIR调度的三节点集群(含一台RTX 5090笔记本和一台DGX Spark)后,只用8分48秒,提速一倍以上。英伟达产品经理还算过一笔账:一个拥有四台高性能设备的家庭,闲置算力约165 TFLOPS,”这是一座躺在千家万户里的免费Token宝藏”。
| 方案 | 成本 | 数据隐私 | 并行能力 | 适合场景 |
|---|---|---|---|---|
| NVIDIA PAIR(本地组网) | 免费开源,仅电费 | 数据不出内网 | 多任务并行,机器越多越快 | 多智能体批量任务、隐私敏感内容 |
| 单机Ollama直跑 | 免费,但受单卡限制 | 本地安全 | 任务排队,GPU易成瓶颈 | 轻度单任务使用 |
| 云端API订阅 | 每月几十到上千元 | 数据上传第三方 | 弹性强 | 无本地显卡、追求省心 |
优缺点都很明显:它是任务分发器,不是超级计算机
优点方面:完全免费开源,零订阅费;数据全程留在局域网,隐私可控;跨平台支持连Mac都能纳入集群;设备随插随用、随走随撤,你在台式机上打游戏时,AI任务会自动迁到别的机器。
但缺点必须说透:PAIR不能把多块显卡合并成一块”大显卡”。它不做显存池化,也 无法把单个推理请求拆到多台机器上跑——每个请求必须完整地在一台设备上执行。这意味着:如果你跑的是30B以上、单机显存装不下的大模型,PAIR帮不了你;如果你的任务是高度串行的单一长请求(比如一次性长文生成),提速也很有限。它的价值来自”有闲置硬件+有可并行的任务”,两个条件缺一个,收益都会打折。
哪些人值得装:对号入座
如果你是每天跑多智能体任务的开发者、有旧游戏本想废物利用的折腾党、或对数据隐私敏感不想把文件传云端的用户,PAIR是目前成本最低的本地算力扩容方案,值得一试。如果你只有一台电脑,或主要跑单次长推理任务,先观望即可。顺带一提,本地推理省下的Token费用,和此前OpenAI自研芯片推动的推理成本战是同一个大趋势——AI算力正在从云端向边缘回流。想了解智能体任务的更多玩法,可以看这篇豆包工作实测。
一句话总结:如果你家里有两台以上带RTX显卡或M4芯片的电脑在闲置,NVIDIA PAIR是当前唯一免费、开源、数据不出门的”家用AI算力组网”方案——装上不亏。