
你是否遇到过这种情况:把一份两三百页的产品文档丢给 AI,它读到后面就开始编造细节;想让它同时改三个文件,上下文窗口先撑爆了。换更贵的旗舰模型,一个月账单又让人心疼。Anthropic 在 6 月 30 日上线的 Claude Sonnet 5,就是冲着这个矛盾来的。
一、Claude Sonnet 5 是什么:Sonnet 的价格,干 Opus 的活
Claude Sonnet 5 在 2026 年 6 月 30 日发布,上线当天就成了 Claude 免费版和 Pro 版的默认模型——你如果最近打开 claude.ai 没手动改过设置,现在用的就是它。
三个关键参数先摆出来:
- 上下文窗口 100 万 token,整仓代码、整本手册可以一次塞进去
- 模型 ID 为
claude-sonnet-5,API 和 Claude Code 都靠这个字符串切换 - 默认开启 cyber safeguards,命中高风险请求时会把该次查询重定向到更小的模型
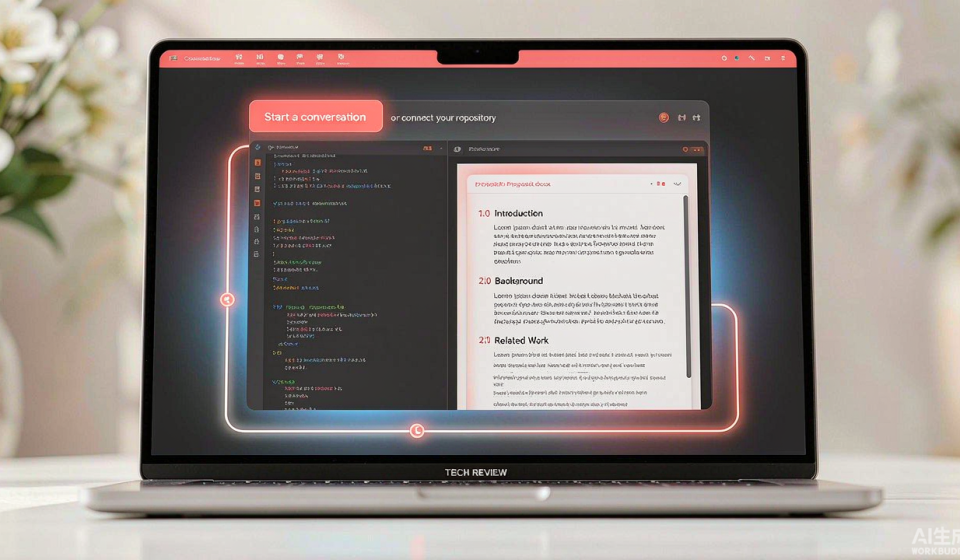
界面上和之前的 Claude 差别不大:左侧是会话与项目列表,中间对话区,右侧可以展开 artifacts 与文件面板,输入框左下角是模型选择器。真正的变化在下面这个下拉框——”Sonnet 5″ 现在是排在最上面那一项。
三条上手路径:
- 网页版:登录 claude.ai 即可,免费账号无需任何设置,默认就是 Sonnet 5
- API:把请求体里的
model字段改成claude-sonnet-5,其他参数不用动 - Claude Code 命令行:输入
/model后选择 sonnet-5,或在配置文件里写死模型 ID
如果你正在做多 Agent 或自动化任务编排,可以顺手看看我们之前测过的 Microsoft Scout 后台智能体实测,两者在长任务托管上是互补而非替代关系。
二、实测数据:它到底比谁强,贵不贵
先看一组 Anthropic 官方与第三方跑分。Sonnet 5 在 SWE-bench Pro 上拿到 63.2%,Terminal-Bench 2.1 为 80.4%,OSWorld-Verified 为 81.2%;在衡量真实职业任务质量的 GDPval-AA v2 上拿到 1618 Elo,比 Opus 4.8 的 1615 还高 3 分。换句话说,在多数日常编码与 Agent 任务上,它已经不是”接近旗舰”,而是”就是旗舰”。
| 对比项 | Claude Sonnet 5 | Claude Opus 4.8 | Gemini 3.5 Flash |
|---|---|---|---|
| 上下文窗口 | 100 万 token | 100 万 token | 100 万 token |
| SWE-bench Pro | 63.2% | 更高(未公开) | 55.1% |
| Terminal-Bench 2.1 | 80.4% | — | 76.2% |
| OSWorld-Verified | 81.2% | — | 78.4% |
| GDPval-AA v2 | 1618 Elo | 1615 Elo | — |
| 输入价 / 百万 token | $3 | 显著更高 | $1.5 |
| 输出价 / 百万 token | $15 | 显著更高 | $9 |
| 免费档可用 | 是(默认模型) | 否 | 有限额度 |
价格这里有个坑要提醒:Sonnet 5 发布时给的是优惠价——每百万 token 输入 $2、输出 $10,优惠期到 2026 年 8 月 31 日结束。从 9 月起已恢复标准价 $3 / $15。现在是 10 月,你接的就是标准价,别再按网上那些 $2/$10 的旧文章算成本。
速度方面,日常对话首字延迟在 1 秒内,跑长上下文检索时明显比同价位模型稳,不会出现”读着读着就忘”的情况。订阅制这边 Claude Pro 仍是 $20/月,包含 Claude Code、Cowork 等组件,免费档额度也够做轻量日常任务。
三、不吹不黑:三个优点,三个短板
优点:
- 性价比是真的。用 Sonnet 的价位干 Opus 的活,对 API 用户来说这是今年最实在的一档。
- 100 万上下文确实能用。不是纸面数字,整本手册 + 整个仓库一起问,检索命中率明显高于上一代。
- 零成本试错。免费账号默认就是它,不用付费就能验证适不适合自己的工作流。
短板:
- 新 tokenizer 推高了英文成本。同样的英文文本,分词后大约多出 30% 的 token,账单会比按旧分词器估算的高。中文场景影响小得多。
- 一步成型的视觉构建偏弱。让它一次性生成完整可交互的前端页面,效果不如 GLM 5.2 这类专门调优过的模型。
- 有边界限制。社区反馈过 temporal-dead-zone 之类的代码 bug 案例;cyber safeguards 默认开启,部分安全研究类请求会被静默重定向到小模型,输出质量会掉一个档。
四、谁该换,谁别换
建议立刻换的:日常写代码、长文档分析、需要工具调用与 Agent 行为的任务;以及预算敏感但又想要旗舰体验的人。配合我们之前介绍过的 OpenCode 开源编程智能体,把底层模型指向 claude-sonnet-5,能在不付 IDE 订阅费的前提下拿到接近 Cursor 的体验。
可以再观望的:主力场景是英文长文本且对成本极度敏感(新分词器会吃掉一部分优势)、需要一次性生成高完成度前端界面、以及工作涉及安全研究边界请求的人。
一个实操建议:API 用户别做二选一,做多模型路由——把 Sonnet 5 设为默认主力,把需要极致推理的少量请求留给更贵的模型,日常批量任务可以分流到 Gemini 3.5 Flash($1.5/$9)。订阅用户则直接把默认模型锁成 Sonnet 5,不用额外花一分钱。
总结
把日常任务的默认模型换成 Claude Sonnet 5,是 2026 年下半年性价比最高的一次调整——先用免费账号跑一周真实任务,再决定要不要把 API 也切过去。