
你是否也遇到过:智能体项目跑一个月,token账单比服务器租金还贵;想换便宜模型,编码能力又掉一大截。9月10日DeepSeek上线的V4.1-Flash把这两个问题一起处理了——官方直接让上一代旗舰V4-Pro给它让路。它到底值不值得切换?看完这篇实测你就有答案。
一句话看懂V4.1-Flash:非对称MoE架构拆解
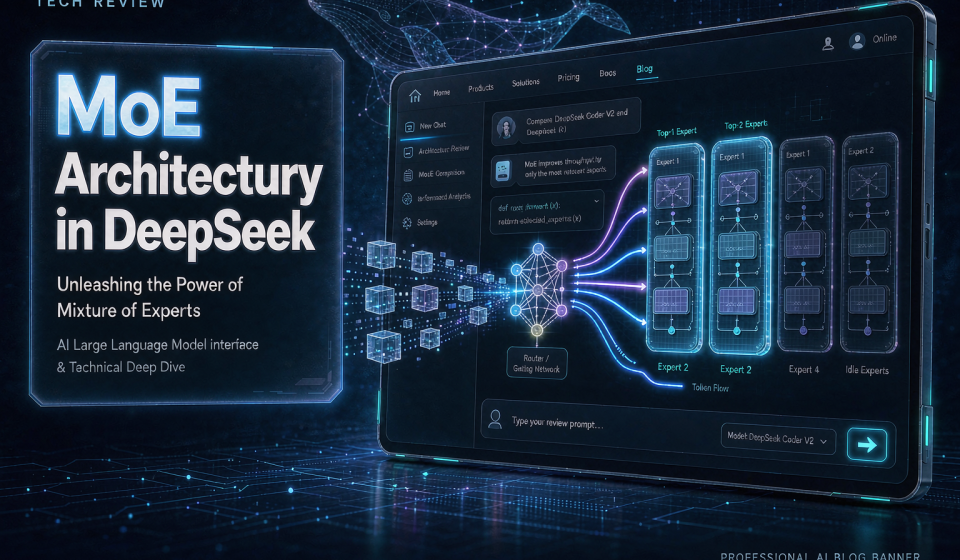
V4.1-Flash总参数552B,采用了全新的Causal Encoder-Decoder非对称架构:40层Transformer拆成20层编码器加20层解码器,输入阶段只激活8B参数,输出阶段激活16B。翻译成人话:模型”读”的时候更省算力,”写”的时候才动用更大的参数量。配合Compressed Sparse Attention 2与FP4 KV缓存,每token的KV缓存被压到890字节,只有上一代的1/4,持久化存储降到1/8。
这笔账为什么重要?缓存命中费用是智能体成本的大头——代码助手反复读代码库、RAG应用反复载入同一批文档,都靠缓存省钱,缓存压得越小,这部分开销越低。此外,V4.1-Flash原生支持视觉输入(图片+文字),上下文窗口1M token,权重以MIT协议在Hugging Face开源。9月14日起,原来的deepseek-v4-pro请求已自动路由到V4.1-Flash,按新价格计费。
实际体验:速度拉满,价格卷到地板
实测生成SVG代码比上一代视觉实验版快约6倍,长文档检索快5倍多,输出速度每秒三四百token,字几乎是往外喷的;第三方在max effort档实测输出214.4 token/s,依然很快。价格方面(每百万token):
- 闲时:输入$0.15、输出$0.60、缓存命中输入仅$0.003(折合人民币约1元、4元、2分钱);
- 高峰时段(周一至周五UTC 1:00-4:00与6:00-10:00,即北京时间9点至12点、14点至18点):全部翻倍。
算一笔具体账:一个50万token的可复用前缀缓存跑100次请求,V4.1-Flash闲时约$0.15;同样场景下Kimi K3约$15、GPT-5.6 Sol约$20、Claude Opus 5约$25,差距接近百倍。上手只需三步:注册DeepSeek开放平台→模型名填deepseek-flash→走OpenAI兼容接口调用,现有代码改一行base_url就能切换。WorkBuddy和OpenCode也已官方支持该模型。
跑分对比:追平Opus 5,但只在你选的场景里
官方公布的跑分确实亮眼,我们把它和两家闭源旗舰放在一起看(含价格):
| 维度 | DeepSeek V4.1-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1(终端智能体) | 90.6 | 89.1 | 88.8 |
| DeepSWE v1.1(软件工程) | 74.2 | 74.0 | 73.0 |
| Terminal-Bench 4.0(复杂任务) | 31.2 | 51.8 | 39.9 |
| HLE无工具(通用推理) | 36.8 | 56.3 | 44.5 |
| 闲时输出价($/百万token) | 0.60 | 25 | 20 |
在智能体和编码基准上,它确实追平甚至小胜两家闭源旗舰,但HLE这类通用推理差了近20分,Terminal-Bench 4.0也明显落后。Artificial Analysis综合指数40,落后Opus 5(51)11分。结论很清晰:它是”智能体执行型”选手,不是”闭卷思考型”选手——接入工具后HLE从36.8跳到63.9,说明它强在动手干活,不在凭空硬想。想横向比较其他国产模型编码能力,可以参考我们此前的Qwen3.8-Max-0902实测与Gemini 3.8 Flash评测。
优缺点分析与适用人群
优点:价格是地板级;编码与智能体能力真实够用;1M上下文加原生视觉;MIT开源可自由部署、商用无限制。
缺点:输出偏啰嗦,思考token比同级模型多约79%,长推理调用会吃掉一部分价格优势;官方自己承认稀疏选择错误和缓存恢复边界存在未验证的鲁棒性风险;本地部署门槛极高——权重475GB,单卡用户基本告别,社区里5GB内存跑起来的方案也只有每秒几token,观赏意义大于实用。
适合谁:高频调用API的智能体开发者、长文档RAG项目、批量数据处理、预算敏感的独立开发者。不太适合:需要顶级通用推理的科研场景,以及想在游戏本上自部署的极客。
一句话总结:如果你在跑高频智能体或RAG项目,V4.1-Flash是当前性价比没有对手的选择——编码任务先上Flash,撞墙了再考虑更强的Pro。