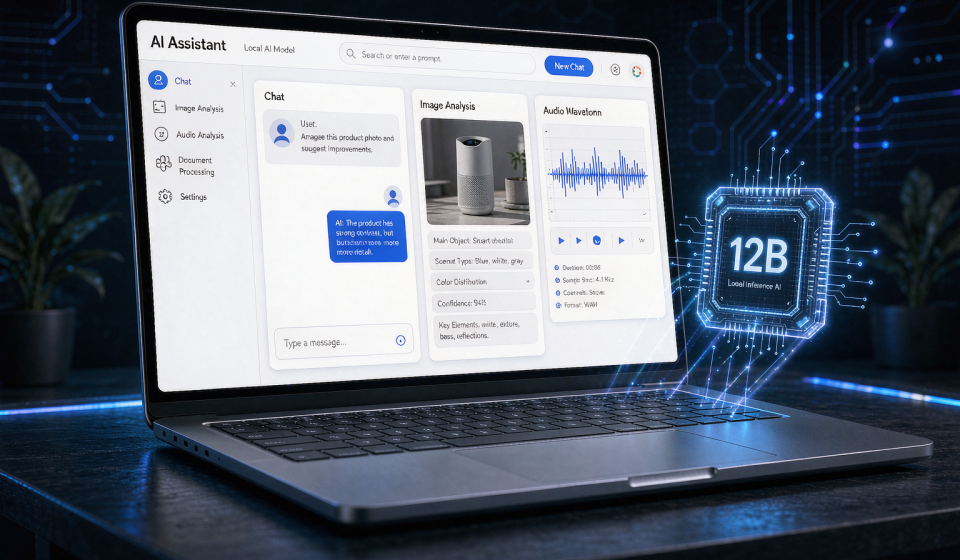

你是否遇到过这种情况:想把AI用在涉密文档、客户合同或者私人笔记上,却因为”数据要上传云端”而不敢动手?或者受够了每月20美元的订阅费和按量计费的API账单?2026年6月3日谷歌发布的Gemma 4 12B,把这两个问题一起解决了——一个免费开源、能看图、能听音频、还能完全离线运行的多模态模型,16GB内存的普通笔记本就带得动。
一、Gemma 4 12B是什么:把”编码器”砍掉的统一多模态模型
Gemma 4 12B是谷歌Gemma 4开源家族新增的中档成员,约119.5亿参数,采用Apache 2.0许可证——可以免费下载、修改、商用,没有任何按token计费。它最大的技术亮点是”无编码器统一架构”:传统多模态模型要靠单独的视觉编码器和音频编码器先”翻译”再交给语言模型,而Gemma 4 12B把图像块和原始音频波形直接投影进同一个Transformer主干。音频编码器被整个删除,视觉模块只保留一个3500万参数的轻量投影层(一次矩阵乘法)。好处很直接:多模态输入的延迟和内存开销大幅下降,微调时一份LoRA就能同时覆盖文本、图像、音频三种模态。
它支持256K token上下文(约200页文档),可输入文本、图片、30秒音频和60秒视频,输出为文本。芯片层面还配了多Token预测(MTP)草稿模型来降低响应延迟。
二、三步部署教程:Ollama一条命令跑起来
上手门槛极低,以最常见的Ollama为例:
第1步:到ollama.com下载安装包(Windows/Mac/Linux都有),装完自动后台运行,默认监听localhost:11434。
第2步:终端输入ollama pull gemma4:12b,下载默认4bit量化版本,磁盘占用约7.6GB,Q4_K_M量化是16GB内存笔记本的最优选。
第3步:输入ollama run gemma4:12b进入对话。喂图也很简单:ollama run gemma4:12b "总结这张截图的重点" ~/Desktop/截图.png,全程数据不出本机。
不想敲命令可以用LM Studio图形界面:搜索Gemma 4 12B,选GGUF格式Q4_K_M量化下载,加载即可聊天。独显用户在Ollama前置OLLAMA_NUM_GPU=35可分层挂载到显卡提速。还有一个必踩的坑要提醒:Ollama默认上下文窗口只有4K,而Gemma 4 12B实际支持256K,长文档场景记得通过自定义Modelfile把num_ctx调大。
三、实测对比:9GB显存逼近26BMoE,碾压上代27B
官方基准里,Gemma 4 12B的推理成绩已接近自家26B MoE大模型,而内存占用不到后者一半。和上一代旗舰Gemma 3 27B同台对比,12B全面胜出:
| 对比项 | Gemma 4 12B(2026-06) | Gemma 3 27B(上代旗舰) |
|---|---|---|
| 参数量 | 11.95B 密集 | 27B 密集 |
| MMLU Pro 推理 | 77.2% | 67.6% |
| AIME 数学 | 77.5% | 20.8% |
| LiveCodeBench 编程 | 72.0% | 29.1% |
| GPQA Diamond 科学 | 78.8% | 42.4% |
| Codeforces ELO | 1659 | 110 |
| 上下文窗口 | 256K | 128K |
| 许可证 | Apache 2.0(免费商用) | 旧版Gemma条款 |
实测数据也印证了这一点:有开发者在单张RTX 4090上让它和26B MoE比拼”不用任何库、单文件手写HTML5 Canvas物理动画”(高尔顿板、方块碰撞、混沌三摆三个场景),12B以80 token/s的速度完成了全部场景的通关,显存占用仅9GB;26B虽然跑到138 token/s,却要吃掉15GB显存。换句话说,一半的体量打出了几乎同档的战绩。如果不想自建硬件,第三方托管API(如SiliconFlow)的价格约为每百万输入token 0.10美元、输出0.30美元,比主流旗舰API便宜一个量级。
四、优缺点分析与适用人群
优点:①完全免费开源,Apache 2.0无商用限制;②16GB内存即可离线跑,数据不出本机;③原生多模态(图/音频/视频输入)在这个参数档是独一份;④256K长上下文+工具调用,具备本地Agent基础;⑤生态成熟,Ollama、LM Studio、llama.cpp、vLLM、MLX开箱即用。
缺点:①输出只有文本,不能生成图像/音频;②音频输入单次上限30秒、视频60秒,长录音要切片;③复杂多步推理仍落后26B/31B版本;④Ollama默认4K上下文配置对新手是隐形坑;⑤没有官方托管API,云端部署要靠第三方。
适合谁:处理敏感文档的政企/法务/医疗从业者、想零成本折腾本地AI的学生和独立开发者、需要离线可用场景(出差、无网环境)的用户。如果你只是要最强推理能力,请直接用云端旗舰模型;但如果你的核心诉求是”免费+私有+够用”,它目前就是16GB笔记本上的最优解。想进一步搭建本地智能体工作流,可以配合我们之前介绍过的DeepSeek Harness桌面版评测阅读;想了解在线侧的同类能力,也可以看看Gemini Skills教程。
一句话总结:Gemma 4 12B用一台普通笔记本的成本,把多模态AI的订阅费和隐私焦虑一起清零——16GB内存的用户,今天就值得装一个。