
你是否也遇到过:手里一堆扫描版合同、发票或论文PDF,想喂给AI做知识库,结果解析出来表格散成一堆乱码,公式变成怪符号,连答案出自原文哪一页都说不清?9月我把一条跑了半年的RAG文档解析流水线迁移到了Mistral OCR 4,这篇把实测体验、成本账和踩过的坑一次讲清。
它不只是“认字”,还告诉你字在哪、是什么、有多可靠
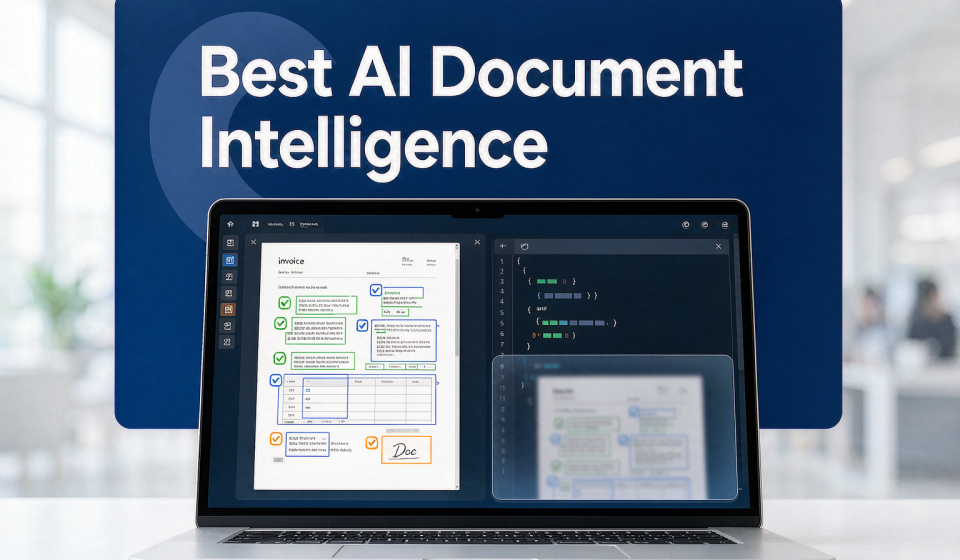
Mistral AI在6月23日发布了OCR 4,7月16日又升级到4.1(块级置信度)。相比上一代只输出干净的文字和表格,这一代的核心变化是每个文本块都带三样东西:
- 坐标(bounding boxes):返回每个文本块的像素级框选坐标,前端可以直接在原页面上高亮出处;
- 块类型分类:标题、段落、表格、公式、签名、页眉页脚等自动打标;
- 置信度分数:支持页级、词级、块级三档粒度,低置信度区块可以直接路由给人工复核。
支持PDF、DOC、PPT和OpenDocument格式,覆盖170种语言。上手只要三步:到console.mistral.ai注册并生成API Key,安装官方SDK(pip install mistralai),然后调用ocr接口:
from mistralai import Mistral
client = Mistral(api_key="YOUR_KEY")
resp = client.ocr.process(
    model="mistral-ocr-latest",
    document={"type": "document_url",
              "document_url": "https://example.com/invoice.pdf"},
    include_blocks=True, table_format="html")
for page in resp.pages:
    for b in page.blocks:
        print(b.type, b.bbox, round(b.confidence, 3))
我拿一份中英混排的扫描发票实测:表格完整还原成了HTML结构,签名区域被标为signature类型、置信度0.882,金额栏0.964。返回的Markdown保留了标题层级和表格结构,清洗后可以直接进向量库,不用再写一堆正则去猜段落边界。
成本账:4美元一千页贵不贵,要看你跟谁比
先看基准成绩:OlmOCRBench 85.20(发布时榜首)、OmniDocBench 93.07;在600多份真实文档的盲测中,人类标注员有72%的对比更偏好OCR 4。客户Rogo报告,同等准确率下成本约为原方案的1/8、延迟约1/17。吞吐方面,单张GPU每分钟最多处理2000页。
价格才是它最锋利的地方。单独看4美元/千页(批量API半价2美元),比云厂商1.5美元的纯文本OCR贵;但一旦需要表格、表单、坐标这类结构化输出,格局立刻反转:
| 服务商 | 纯文本OCR | 结构化提取(表格/表单) | 自托管 |
|---|---|---|---|
| Mistral OCR 4 | $4/千页(批量$2) | 基础价内含,Document AI模式$5/千页 | 支持,单容器 |
| AWS Textract | $1.50/千页 | 表格$15、表单$50、组合$70 | 不支持 |
| Google Document AI | $1.50/千页 | Layout Parser $10、自定义提取$30 | 不支持 |
| Azure Document Intelligence | $1.50/千页 | 自定义提取约$30 | 支持断连容器 |
算一笔实际账:每月处理10万页结构化文档,AWS Textract的表单+表格组合要700美元,OCR 4的Document AI模式只要50美元。如果你的流水线真的消费坐标和置信度,OCR 4直接打穿了三大云厂商10到70美元的结构化档位。
优点很硬,短板也别装看不见
优点:结构化输出开箱即用,省掉自建版面检测层;170种语言对多语种档案友好;批量API直接半价;单容器自托管对有数据驻留要求的合规团队是刚需级能力。
短板:一是纯文本场景下它比云厂商贵一倍多,用不上结构化能力就是白花钱;二是官方明确不适用于医疗诊断、法律判断和高风险金融决策;三是72%盲测胜率是厂商自己的评测设计,手写体、低质量扫描件建议先拿自己的文档实测;四是个小坑——mistral-ocr-latest别名已静默指向4.1,老流水线最好确认一下行为没变。
适合谁用,谁可以绕开
三类人建议上手:搭RAG或企业搜索的知识库工程师(配合开源的Mistral Search Toolkit,结构化块直接变引用就绪的检索单元);批量处理发票、合同、卷宗的自动化团队;有数据不出域要求的合规型企业。而如果你只是想把文字版PDF转成Markdown,免费的MarkItDown或Docling就够用,不必为此付费。
扩展阅读:想看AI办公文档自动化的另一种思路,可以参考此前豆包工作实测;做开发者流水线的,GitHub HydraFusion实测里有多模型编排的成本对比。
一句话总结:如果你正为文档进AI知识库的“最后一公里”发愁,Mistral OCR 4是目前结构化解析里性价比最狠的正规军——先用免费额度跑100页试试,再决定上不上量。